1.3. Кодирование символов
Также как и в других областях, связанных с использованием программных средств, в WWW используется понятие кодовой страницы (кодировки). Принципы кодировки заложены в стандарте ANSI (в который входит и стандарт ASCII), где для кодирования символа используется один байт, и, следовательно, числа от 0 до 255. Весь машинный алфавит разделен на две кодовые страницы (с кодами 0-127 и 128-255). Первая часть алфавита является стандартной, она содержит знаки пунктуации, числа и латинские буквы (рис. 1.1). Коды 0-31 зарезервированы для символов, которые обычно не отображаются на экране (например, код перевода строки).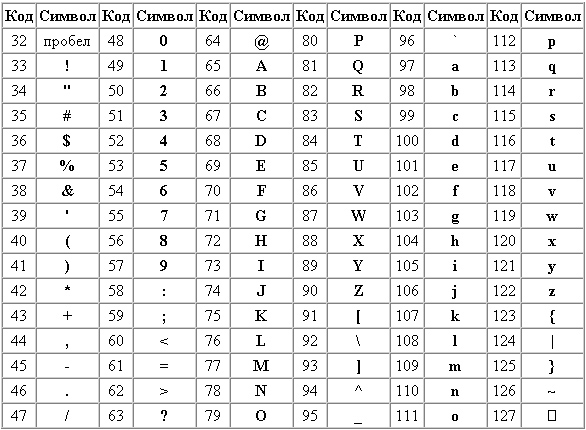
Рис. 1.1. Коды ANSI
Вторая половина кодовой таблицы содержит символы еще одного национального алфавита, поэтому в разных ситуациях одним и тем же кодам могут соответствовать разные символы. Даже для кириллицы используется несколько кодировок, самые популярные из них — Windows-1251 и KOI-8R. Поэтому информация о кодовой странице часто включается в состав Web-страницы. Например, часто необходимо использование элемента META:<META http-equiv="Content-Type"
content="text/html; charset=windows-1251">
Такой подход позволяет использовать тексты на различных языках (французском, немецком и т.п.), но не позволяет использовать любые символы одновременно. По умолчанию используется кодировка ISO Latin 1 (ISO 8859-1). Она используется как в MS-DOS (набор символов ASCII), так и в Windows, поэтому набор программ для просмотра и редактирования кода HTML, достаточно широк.
Если в документе не указана определенная кодовая страница, выбор шрифта остается за броузером. Коды 32-127 отображаются в подавляющем большинстве случаев правильно, а коды 128-255 могут отображаться по-разному, поэтому с состав меню броузера включена команда для выбора кодировки.
Более прогрессивным средством отображения символов является кодировка Unicode 2.0 (ISO10646), которая позволяет использовать любые национальные алфавиты. С этой системой совместим и стандарт ISO UCS-2 (Universal Character Set), который тоже использует двухбайтовое кодирование символов.
В различных программах и операционных системах символы могут кодироваться как однобайтовым числом (коды в пределах 0-255), так и двухбайтовым (коды в пределах 0-65535). В большинстве случаев Web-страницы создаются в стандарте ANSI.
Во всех системах кодирования (из соображений совместимости) совпадают только коды 0-127, поэтому во многих случаях необходимо использовать буквы только латинского алфавита (в Интернет-адресах, именах переменных, именах идентификаторов элементов, именах стилей, именах файлов и т.д.).
Символы Unicode в тексте Web-страницы могут использоваться только с помощью специальных кодов. Например, русская бука А будет выглядеть так: А.
Для использования символов, которые нельзя ввести с клавиатуры, разработана система мнемокодов (рис. 1.2). При этом символ можно задать двумя способами (буквенным и числовым кодами). Например, амперсанд может быть задан двумя способами: & и &. В конце буквенного обозначения обязательно ставится точка с запятой. По числовому коду можно понять, к какой системе кодирования относится символ. Если код меньше 255 — это кодировки ANSI или Unicode. Коды с большими значениями относятся только к Unicode.
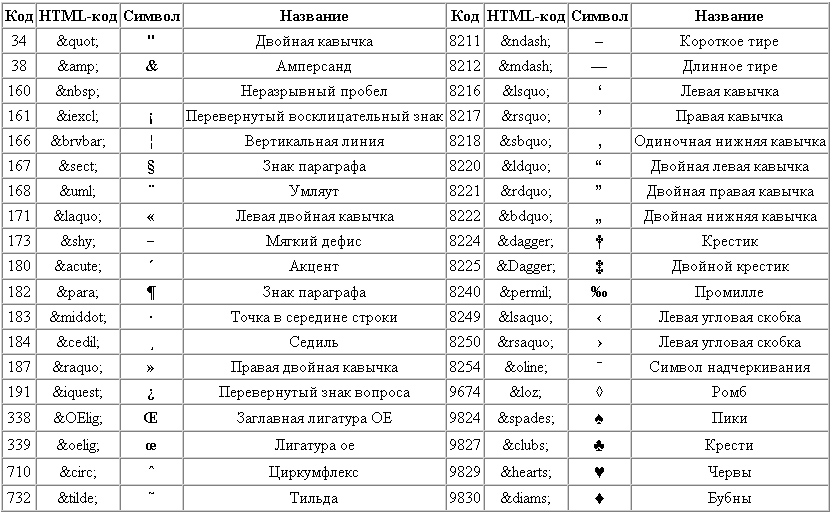
Рис. 1.2. Мнемокоды некоторых полезных символов
Некоторые мнемонические коды чувствительны к регистру букв. Например, коды ‡ и † соответствуют разным символам. Зависимость от регистра используется и для кодирования букв: если мнемокод начинается с заглавной буквы, то и броузер воспроизводит заглавную букву, а в противном случае — строчную (например, Α и α). На рис. 1.3 показаны мнемокоды заглавных греческих букв. Стандарт ISO10646 включает также набор модифицированных латинских букв (с тильдами, умляутами и т.п.).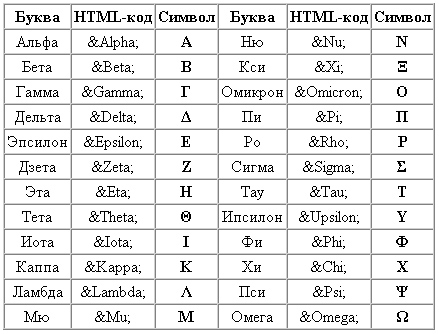
Рис. 1.3. Мнемокоды греческого алфавита
На рис. 1.4 показан набор символов для коммерческого применения.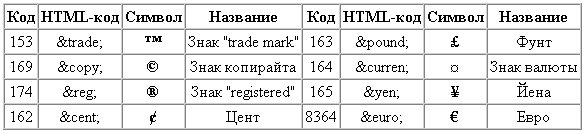
Рис. 1.4. Коммерческие символы и знаки валюты
Достаточно много предусмотрено и математических знаков. На рис. 1.5 показаны некоторые из них. На самом деле их больше, но не все указанные в стандарте символы отображаются броузерами (в данном случае для тестирования использовался Internet Explorer 6.0).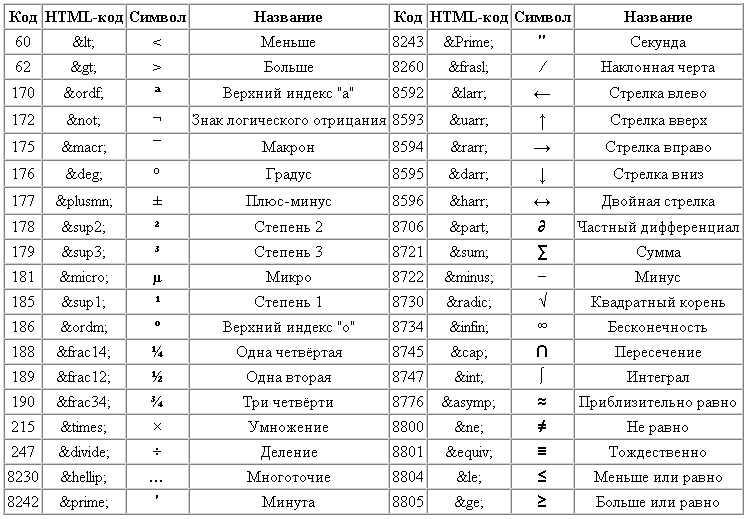
Рис. 1.5. Математические символы
Иногда требуется использование невидимых символов. К таким символам относится, например, «мягкий перенос» ­, указанный выше. Обычно этот символ не виден, но, в некоторых случаях, когда строка не умещается на экране, с его помощью выполняется перенос (в слове), и тогда символ приобретает вид дефиса. Есть ряд других невидимых символов:HTML-код |
Название |
	 |
Табулятор |

 |
Конец строки (line feed) |
 |
Конец страницы (form feed) |

 |
Возврат каретки (carriage return) |
  |
Пробел |
- |
Дефис |
  |
Неразрывный пробел |
​ |
Пробел нулевой ширины |
© TEKCT.RU, А. Гончаров, 2007-2022
|
|